一、AI 视频模型与平台介绍
1. 常见模型与基础概念
模型是"生成能力"的提供方,比如:Seedance 2.5、 Minimax H3
平台是"使用模型的地方",比如:小云雀、即梦、flova
1.1 文生图、文生视频、图生视频三者的区别是什么呢?
|
生成方式
|
输入
|
输出
|
典型用途
|
上手难度
|
|---|---|---|---|---|
|
文生图
|
一段文字描述
|
单张图片
|
定妆照、分镜图、海报素材
|
低
|
|
文生视频
|
文字描述(可含镜头与运镜)
|
一段视频
|
从零构思剧情、场景演示
|
中
|
|
图生视频
|
一张或多张参考图 + 提示词
|
一段视频
|
让已确定的角色、场景动起来,一致性最好
|
中
|
1.2 文生视频和图生视频该怎么选择呢?
只有画面想法,用文生视频;已经有想保留的画面,用图生视频。
|
文生视频
|
图生视频
|
|
|---|---|---|
|
适合什么时候
|
从零探索场景、风格和镜头
|
已确定人物、产品或场景的外观
|
|
你提供什么
|
用文字描述画面和变化
|
参考图+希望发生的动作
|
|
主要优势
|
创作空间大,适合快速试想法
|
起始画面更可控,便于延续视觉风格
|
|
主要难点
|
人物长相、服装、产品细节可能偏离预期
|
动作幅度大时仍可能变形,参考图也会限制构图
|
比如:
想做“一只猫在月球上开咖啡馆”,还没想好猫和店铺长什么样 → 文生视频,先探索效果。
已有角色定妆照,希望她转头、微笑、走路 → 图生视频,更容易保持角色外观。
已有保温杯产品图,希望镜头绕杯身移动 → 图生视频,但 Logo、文字和结构仍需检查。
只需要一段雨夜街景、云海或科幻城市素材,没有必须一致的主体 → 文生视频。
做连续剧情时,也可以组合使用:先生成并选定角色和分镜图片,再用图生视频让各个镜头动起来。
2. 主流视频模型怎么选?大概需要花多少钱?
现在视频模型有很多,大家可以根据自己手里的预算,还有想要制作的视频类型进行选择。
如果你做一些产品的广告,MiniMax H3 的性价比是最高的。
如果你要做一些比较复杂或者是质感很高的短片,大部分人还是会选择Seedance 2.5模型。
下面这 7 款模型,可以作为入门时的候选。表里的场景是选择方向,不代表某种视频只能用某款模型。
|
模型
|
什么情况下可以先试它
|
|---|---|
|
可灵 2.5 Turbo
|
已经有一张人物图或产品图,想做动作、运镜,先生成几个镜头看看效果。
|
|
MiniMax H3
|
做产品展示、广告,手上有图片、视频等参考素材,希望模型结合这些素材生成画面。
|
|
Wan 3.0
|
想生成一段相对完整的介绍或故事。它支持最长 30 秒输出,也支持根据文档等资料生成视频。
|
|
可灵 3.0 系列
|
做带人物对白、多镜头切换的短剧情。选择时注意具体版本,以及是否开启声音。
|
|
Seedance 2.5
|
画面里有多个人物、多个场景,或者需要参考动作视频、白模视频来控制内容;也适合需要继续修改已有片段的任务。
|
|
Veo 3.1
|
想把画面、对白和环境声一起生成,例如街头对话、生活场景、带声音的故事片段。
|
|
Gen-4.5
|
想尝试广告镜头、氛围画面和不同的运镜效果,尤其是已经在使用 Runway 做视频的人。
|
价格怎么看?先分清你在哪里买。
同一个模型,在官方网页、聚合平台和 API 上的价格可能不同。网页端通常收会员费、扣积分;API 是通过接口调用模型,按实际用量收费。如果你用的是 LibTV、TapNow 等聚合平台,就看这个平台生成前显示的积分,不能直接套用下面的 API 价格。
下面以累计生成约 30 秒视频素材为例,帮助你建立预算概念。金额是生成费用,不是完成一条视频的全部费用。
|
模型与使用渠道
|
约 30 秒素材的费用
|
需要知道的条件
|
|---|---|---|
|
MiniMax H3/阿里云百炼 API
|
768P 约
15 元
;2K 约
24 元
|
只算输出的基础费用。上传参考视频也会计费;每次输入图片超过 5 张,超出部分另收费。
|
|
Wan 3.0/阿里云百炼北京区 API
|
480P 约
9 元
;720P 约
18 元
;1080P 约
36 元
|
按成功生成的视频秒数收费,这里使用的是官方原价。
|
|
可灵 2.5 Turbo/国际站
|
按发布时的 1080P 计费标准,30 秒合计
150 积分
|
发布时为每 5 秒 25 积分。人民币成本取决于你购买积分的价格,当前扣分以生成页面为准。
|
|
可灵 3.0 系列/国际站
|
根据版本、分辨率和声音设置,在生成页面查看扣分
|
不适合统一写成“30 秒多少钱”。原生声音、不同生成模式等都会影响费用。
|
|
Seedance 2.5/火山引擎 API
|
按调用规格与计费量计算,以控制台报价为准
|
不同渠道的价格不能混用;生成前先查看当前规格的报价。
|
|
Veo 3.1/Google Flow
|
免费用户每天有 50 积分
。非 Ultra 用户生成 4 条 8 秒视频:Lite
40 积分
、Fast
80 积分
、Quality
400 积分
|
实际生成的是 32 秒,再剪成 30 秒。免费积分未用完不结转,高峰期可能暂时无法生成视频。
|
|
Gen-4.5/Runway
|
API 约
3.60 美元
;Standard 月付会员按积分用满折算,约
8.64 美元
|
会员实际支付的是每月 15 美元,含 625 积分;30 秒消耗 360 积分。API 和网页会员是两套计费方式。
|
以上价格核对于 2026 年 9 月 22 日,具体以购买和生成页面为准。
如果暂时不想付费,可以先试 Google Flow。 不开通付费会员,也能获得每天 50 积分。如果全部用来生成 Veo 3.1 视频,可以这样算:
|
模式
|
每条消耗
|
50 免费积分能生成多少
|
|---|---|---|
|
Lite
|
10 积分
|
5 条,每条可选 4、6 或 8 秒
|
|
Fast
|
20 积分
|
2 条,剩余 10 积分
|
|
Quality
|
100 积分
|
当天免费额度不够生成 1 条
|
这些积分适合拿来练习提示词、试试画面效果。当天没用完的积分不会累积到第二天,高峰期也可能需要等待。注意扣费按生成的视频条数计算,一次操作如果生成两条,就会扣两条的积分。
还有一笔钱,很容易在刚开始时漏算:重做的费用。
比如,某个镜头生成一次花 6 元,你做了三次才选到满意的版本,这个镜头实际就花了 18 元。参考图、配音、剪辑等费用,还要另外考虑。
所以,刚开始不用急着买年费,也不用一次生成整条片子。先做一个短镜头,看看效果、等候时间和实际扣费。确认能用,再继续往下做,预算会更好掌握。
3. 聚合平台对比
这些平台都有不同的优势,大家可以根据功能做出自己的判断。
不过,用 AI 生成视频的逻辑都是通用的,只要你会用一个平台,后面的平台也就都会用了。
大家可以根据自己的喜好来选择:
• 如果喜欢画布,就选画布类的平台
• 如果更喜欢对话驱动,可以选对话驱动类的平台
• 另外也有一些平台既带对话又带画布
|
平台
|
平台类型
|
核心特色
|
适合人群
|
|---|---|---|---|
|
LibTV
|
聚合平台
|
多模型整合,提供无限画布、剧本生成、角色造型、智能剪辑和 Agent;支持 Blender 白模视频接入。
|
AI 短片、漫剧、产品广告创作者;需要统一管理角色、分镜与素材的人。
|
|
TapNow
|
聚合平台
|
通过画布连接文字、图片、视频和音频,搭建可复用的创作流程;支持克隆社区共享画布。
|
设计师、广告创意、电商视觉团队;喜欢自己搭流程、复用工作流的人。
|
|
Flova
|
聚合平台
|
对话驱动的成片 Agent,结合分镜、素材管理和剪辑时间线;支持手动调整与 Skills 复用。
|
有故事或成片需求,希望通过对话推进制作的个人创作者、短片和 MV 制作者。
|
|
Higgsfield
|
聚合平台(兼有自有创作技术)
|
集成多个视频模型,强调运镜预设、动作参考和 Cinema Studio 等镜头设计工具。
|
产品广告、时尚视觉、音乐短片创作者;重视运镜和视觉效果的人。
|
|
可灵 AI/Kling
|
模型厂商官方平台(快手)
|
提供文生视频、图生视频、动作参考与角色控制;可让参考角色跟随视频中的动作表演。
|
人物表演、舞蹈、角色短片创作者;对人物动作有明确要求的人。
|
|
即梦 AI
|
模型厂商官方平台(字节跳动)
|
中文创作,整合图像与视频生成;支持首尾帧控制,以及局部重绘、扩图等画布功能。
|
中文创作新手、自媒体运营、内容设计师;希望先生成图片再制作视频的人。
|
|
海螺 AI/Hailuo
|
模型厂商官方平台(MiniMax)
|
MiniMax 视频模型的官方入口;支持多种参考素材、原生声音视频生成及编辑,具体取决于所选模型。
|
希望直接使用 MiniMax 模型的创作者;产品展示、广告和创意视频制作者。
|
|
Google Flow
|
模型厂商官方平台(Google)
|
围绕 Google 模型整合图像、视频与声音创作,提供参考素材生成、视频延长、编辑和场景组织。
|
叙事短片、场景镜头、带声音视频素材的创作者。
|
|
Runway
|
模型厂商官方平台(Runway)
|
结合生成、编辑、表演相关工具和自定义工作流,支持角色、分镜、广告等多步骤制作。
|
有剪辑、设计或影视基础的创作者;需要将 AI 接入现有制作流程的团队。
|
按平台主要定位分类;官方平台也可能接入第三方模型,聚合平台也可能拥有自有模型或技术。适合人群是根据功能作出的判断。
二、视频生成步骤与工作流
选好工具以后,我们先弄清楚两件事:一条图生视频是怎么做出来的,以及怎么用提示词把自己的想法说清楚。
这一章先把流程和写法讲明白。等到了第三章,大家再跟着具体案例上手,就会更容易理解每一步在做什么。
第一部分:图生视频的完整制作流程
做一条有多个镜头的视频,可以先按这个顺序来:
写故事 → 定角色和场景 → 列分镜表 → 生成分镜图 → 图生视频 → 剪辑配声。
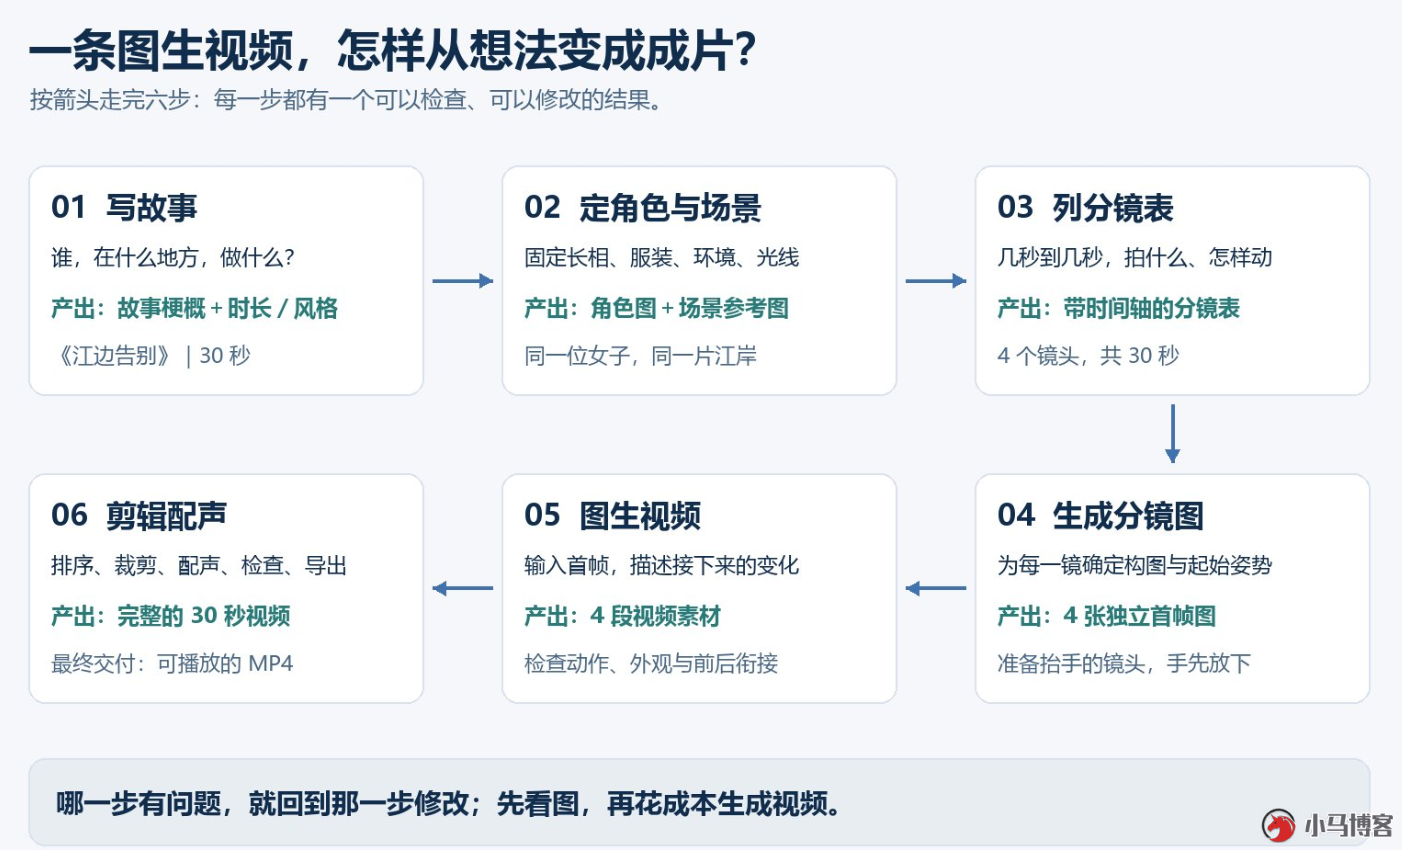
先看每一步要做什么,以及做完以后手里应该有什么。
|
步骤
|
具体做什么
|
这一步的产出物
|
进入下一步前,看什么
|
|---|---|---|---|
|
第一步:写故事
|
想清楚谁在什么地方,发生了什么,最后怎样结束。同时确定大致时长、画幅和风格。
|
一段简短故事,以及“30 秒、16:9、写实风格”这样的基本设定。
|
故事能不能用画面表达?动作和场景会不会太多?
|
|
第二步:定角色和场景
|
写清主角的长相、发型、服装,以及场景的时间、地点、光线;生成或准备相应参考图。
|
选定的角色参考图、场景参考图,以及需要固定的外观说明。
|
人物是否符合预期?服装、环境、风格是否已经确定?
|
|
第三步:列分镜表
|
把故事拆成几个镜头,写清几秒到几秒拍什么、人物做什么、镜头怎样移动。
|
一张带镜头编号、时间、画面、动作和声音的分镜表。
|
时长能否对上?前后动作是否连贯?
|
|
第四步:生成分镜图
|
参考选好的角色和场景,为每个镜头生成对应的画面,确定人物位置、姿势和拍摄距离。
|
一组按镜头编号排列的分镜图;这套流程里,每张图用作对应片段的首帧。
|
是否还是同一个人?场景、光线、人物朝向能否接上?
|
|
第五步:图生视频
|
输入每个镜头的首帧图,描述接下来发生的动作和运镜,分别生成视频。
|
若干段可供剪辑的视频素材。
|
动作是否完成?人物、手部和物体有没有明显变形?
|
|
第六步:剪辑配声
|
按分镜顺序拼接片段,调整时长,配上旁白、环境声、音效或音乐,检查后导出。
|
一条有完整开头和结尾、画面与声音配合好的视频,例如一条 30 秒 MP4。
|
故事是否看得懂?衔接是否自然?声音和总时长是否合适?
|
这是一套方便新手理解和修改的做法。每一步先选定满意的结果,再往下走;后面发现问题,也可以回到对应步骤修改。
其中有几个名字容易混淆,我们放在一起看:
|
名称
|
可以怎样理解
|
|---|---|
|
角色参考图
|
角色的“定妆照”,告诉模型这个人长什么样、穿什么衣服。
|
|
场景参考图
|
故事发生的环境,帮助统一地点、光线和色调。
|
|
分镜表
|
文字版拍摄安排,告诉我们什么时候拍什么。
|
|
分镜图
|
把某个镜头画出来,展示人物位置、姿势和构图,也可以只是草图。
|
|
首帧
|
视频开始的第一张画面。分镜图做得足够完整、适合作为动作起点时,就可以拿来当首帧。
|
比如,一张浅灰背景的女孩全身照,可以用来固定角色外观;但要拍“女孩站在江边”,还需要生成她出现在江边的那张镜头画面。
用一个小故事,把流程串起来
《即梦 Seedance 2.5 使用手册》的长视频部分,有“古装女子江边告别”的 29 秒一镜到底示例。我们借用这个题材,改编成一个 30 秒、4 个镜头的教学示例《江边告别》。
先写一句完整故事:
清晨,一位穿素白古装的年轻女子站在江边,望着远处渐渐离开的小船。她轻轻抬手告别,随后放下手,安静地留在岸边。接着固定角色和场景:女子始终是同一张脸、黑色长发、素白交领衣裙;场景始终是有薄雾的清晨江岸。先准备好人物与江岸参考图,再列出分镜表:
|
镜头
|
成片时间
|
起始画面/分镜图
|
这段视频里发生什么
|
|---|---|---|---|
|
01
|
0–6 秒,6 秒
|
远景,女子站在画面左侧,面向右侧江面,小船在右侧远处。
|
小船缓缓远离,女子安静望着它,镜头固定,交代人物和环境。
|
|
02
|
6–14 秒,8 秒
|
女子的侧面中景,双手自然垂下,朝向与上一镜相同。
|
她慢慢抬起右手,在肩部附近轻轻挥动一次,镜头固定。
|
|
03
|
14–22 秒,8 秒
|
女子脸部近景,视线朝画面右侧,延续望向小船的方向。
|
她的目光停留在远处,嘴角浮现轻微笑意,发丝被风吹动。
|
|
04
|
22–30 秒,8 秒
|
回到侧面中远景,女子右手仍抬在肩部附近,小船已经更远。
|
她缓缓放下右手,继续望向江面,镜头慢慢后退,留出安静的结尾。
|
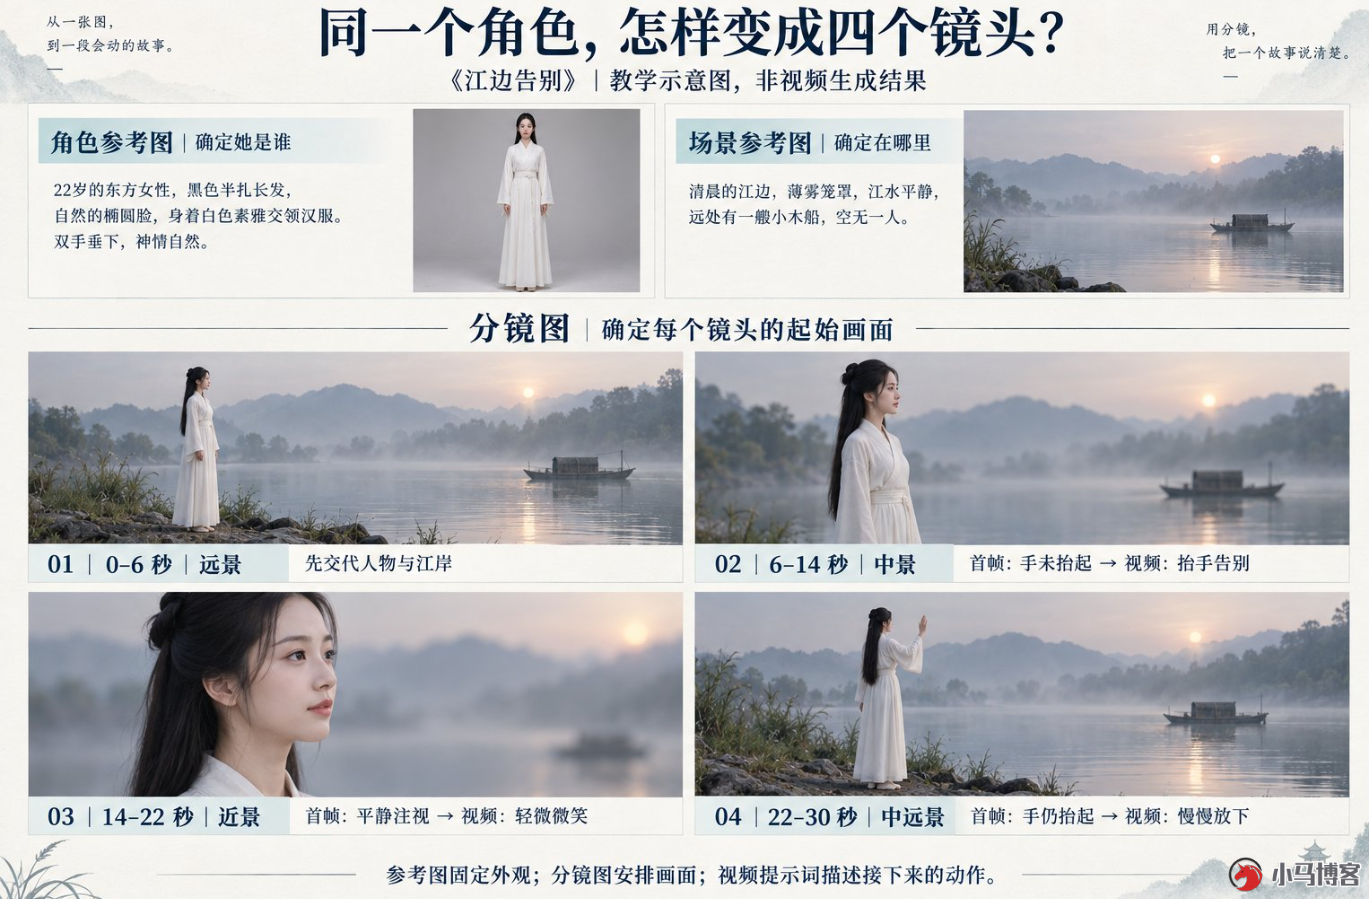
有了这张表,就知道接下来要准备 4 张分镜图、4 段视频素材。例如镜头 02 的图片先画“手还没有抬起”的状态,再让视频表现抬手的过程。不要在一张图里同时画出抬手前和抬手后。
最后把片段按顺序剪在一起,加上连续的江水声和轻微风声,就能形成一条完整短片。音乐和旁白按表达需要添加,不是每条视频都必须有。生成素材的时长可以留一点剪辑余量,最终以剪辑后的 30 秒为准。
这个例子展示的是逐镜头制作。
第二部分:人物、分镜和视频提示词怎么写
知道流程以后,提示词就有了具体用途:生角色图时,要交代外观;写分镜时,要安排画面和动作;生成视频时,还要告诉模型这些动作按什么顺序发生。
可以整理成四个部分:
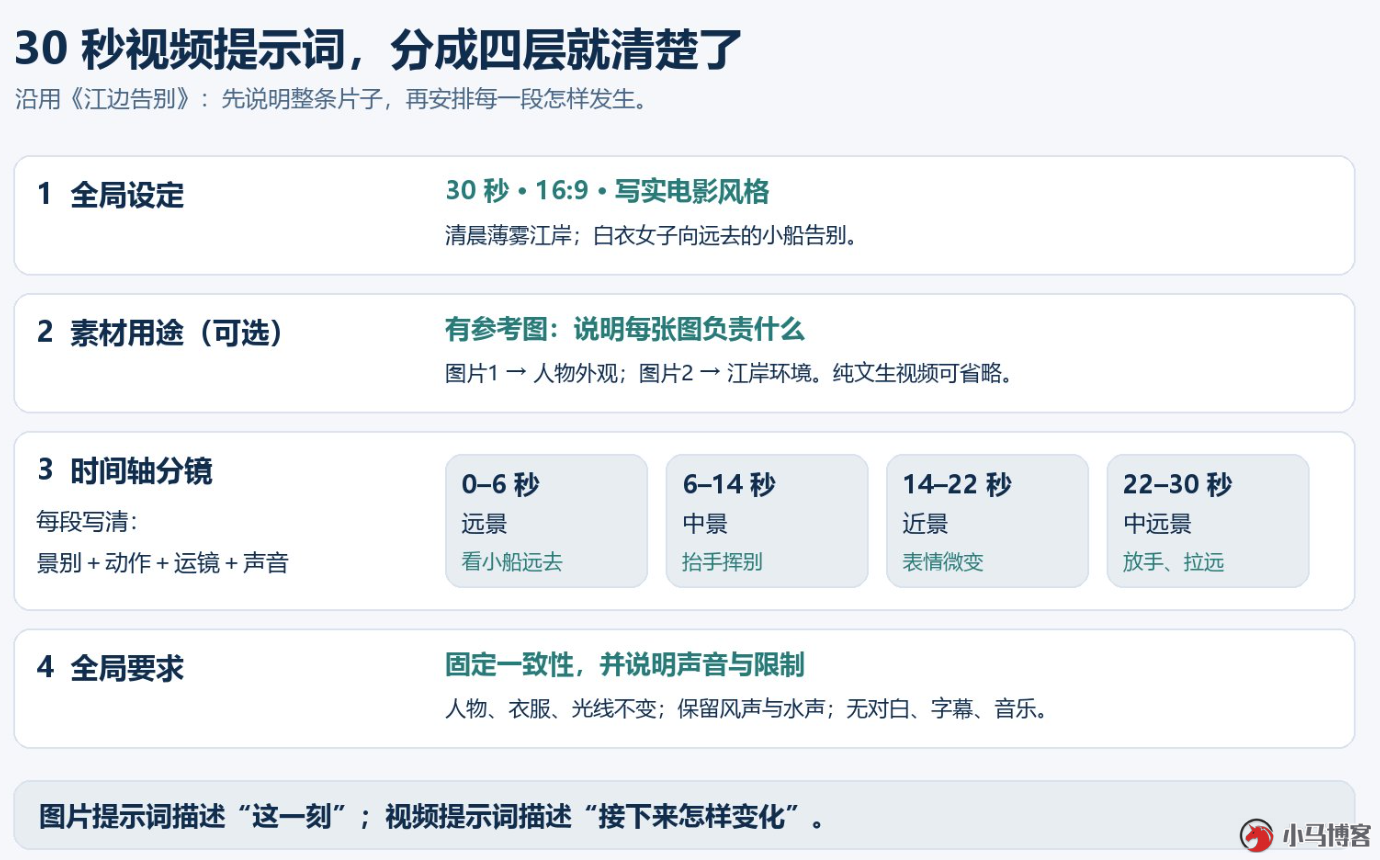
素材用途(有参考素材时)+一句话概述+具体情节+全局要求。
|
部分
|
要回答的问题
|
例子
|
|---|---|---|
|
素材用途
|
上传的每个素材分别用来参考什么?
|
图片1参考人物外观,图片2参考江岸环境。没有素材时可以省略。
|
|
一句话概述
|
谁在什么地方做什么,是什么风格?
|
一位古装女子在清晨江边向远去的小船告别,写实电影风格。
|
|
具体情节
|
先发生什么,后发生什么,镜头怎么拍?
|
0–6 秒拍江岸远景;6–14 秒切中景,女子抬手挥别。
|
|
全局要求
|
整段视频哪些东西要保持一致?需要什么声音?
|
人物长相和衣服不变,保留江水声,无对白、字幕和背景音乐。
|
下面分别看三个常用写法。
1. 人物提示词:把“好看”写成具体特征
只写“一个漂亮女孩”,模型可以有很多种理解。想让人物接近你的想法,就要把最重要的外观说清楚。
真人人物得写法会从年龄、皮肤、面部特征、眼神、发型、服装、体型和气质几个方面描述。新手可以先按下面这张表整理:
|
维度
|
写什么
|
《江边告别》的教学设定
|
|---|---|---|
|
年龄与整体形象
|
大致年龄、人物类型
|
约 22 岁的年轻东亚女性
|
|
皮肤与面部特征
|
肤色、皮肤质感、容易辨认的五官
|
自然肤色,保留细微皮肤纹理,鹅蛋脸,细长眼睛,柔和下颌线
|
|
眼神与表情
|
看向哪里、什么表情
|
目光平静,神情略带不舍
|
|
发型
|
长短、颜色、梳理方式
|
黑色长发,半束发,额前少量碎发
|
|
服装与材质
|
颜色、款式、材质
|
素白交领长裙,柔软布料,没有繁复刺绣
|
|
体态与气质
|
身形、姿态、整体感觉
|
身形纤细,站姿自然,气质温婉
|
把它整理成角色参考图提示词,就是:
写实人物摄影,一位约 22 岁的年轻东亚女性,自然肤色,保留细微皮肤纹理。鹅蛋脸,细长眼睛,下颌线柔和,神情平静。黑色长发半束起,额前有少量碎发。身穿素白交领长裙,布料柔软,没有繁复刺绣。身形纤细,自然站立,双手垂在身体两侧。全身完整入镜,浅灰色简洁背景,光线柔和,脸部和服装清晰,无文字。描述不必越长越好。先固定几项最重要的特征,选好参考图以后,后面的镜头持续引用它。不要每个镜头重新设计一次发型和服装。
2. 分镜提示词:把故事变成拍摄安排
分镜要说清楚“拍哪里”和“发生什么”。可以用一个简单结构来写:
时间段+景别与构图+主体动作/表情+镜头运动+声音。
这里的景别,就是拍摄范围:远景能看见更多环境,中景能看清人物动作,近景更适合表现脸部表情。运镜就是摄像机怎样移动,例如固定不动、缓慢推进、向后拉远。
同样是“她依依不舍地告别”,改成下面这样,画面就具体了:
6–14 秒,侧面中景。女子在画面左侧,望向右侧远去的小船。她缓慢抬起右手,在肩部附近轻轻挥动一次,表情克制。镜头固定,微风吹动发丝和袖口,背景保留轻微江水声。如果想让 AI 先帮你列分镜表,可以这样提问:
请将下面的《江边告别》故事拆成 4 个镜头,总时长 30 秒。表格包含镜头编号、开始与结束时间、景别、起始画面、人物动作、运镜和声音。保持人物、服装、场景与视线方向一致,每个镜头安排一个主要动作。起始画面必须能用单张静态图片表现,检查各段时间连续,合计 30 秒。故事:清晨,古装女子站在江边,望着远去的小船,抬手告别,最后放下手,留在岸边。**列好分镜以后,生图和生视频的提示词还要分开。**生图描述这一刻的画面,生视频描述接下来怎样变化。以镜头 02 为例:
|
用途
|
提示词示例
|
|---|---|
|
生成分镜图
|
人物外观参考图片1,江岸环境参考图片2。16:9 横屏,写实电影风格,清晨薄雾,女子站在画面左侧,侧身面向右侧江面,双手自然垂下。中景,完整保留头部、上半身和双手,右侧留出视线空间。单张画面,无文字。
|
|
让分镜图动起来
|
以上传图片为首帧,女子缓慢抬起右手,在肩部附近轻轻挥动一次,随后保持片刻。目光始终望向画面右侧。镜头固定,发丝和袖口随微风轻动,保持人物外观与场景一致,不切镜。
|
引用图片时,编号要和实际上传的素材对应,并按工具提供的方式选中素材。单独生成某一段视频时,时间从该段的 0 秒算起;分镜表里的 6–14 秒,是它在最终成片中的位置。
3. 30 秒长视频提示词:先统一设定,再按时间展开
30 秒里如果要发生几件事,就需要安排节奏。先交代参考素材和全局设定,再用时间段展开剧情。我们可以整理成下面这个模板:
|
层次
|
写什么
|
|---|---|
|
全局设定
|
总时长、画幅、题材风格、人物外观、场景、时间和光线。
|
|
参考素材(可选)
|
哪张图对应人物,哪张图对应场景,视频或音频分别参考什么。
|
|
时间轴分镜
|
从 0 秒到结束,逐段写出画面、动作、表情、运镜,以及需要的对白或声音。
|
|
全局补充
|
始终保持什么,哪些元素不需要,结尾怎样结束。
|
最后
希望这篇教程,能帮第一次接触 AI 视频的你,从 0 到 1 做出自己的第一个 AIGC 视频。
你可以先让自己的数字人跳一段喜欢的舞蹈,也可以试着写下脑海中的画面,或者参考优秀创作者的提示词结构,让 AI 帮你改写成自己的故事。选一个感兴趣的小玩法,动手生成一次,再看看哪里需要调整。第一条视频不必完美,每一次尝试和修改,都会让你更清楚怎样把想法变成画面。