一、Muse 到底是个啥
Muse 最近很火,但很多人以为它就是个 AI 助手,其实不是,这里我科普下:
Muse 是 Meta 旗下的产品,背后是一整个 Muse 模型家族
负责对话和推理的 Muse Spark
负责生图的 Muse Image
负责视频生成的 Muse Video
而且它跟普通聊天机器人有个本质区别:
每个用户都有一台专属的云电脑,Muse 在上面替你干活——写代码、跑脚本、做视频、管文件,是个能动手执行的智能体,不是个只会动嘴的问答机。
搞清楚这个,就明白为啥可以用 Muse 的视频生成能力,一集一集地生产漫剧。
二、一个 10 秒视频让我入了坑
前几天刷到有人用 Muse 生成的视频镜,质量看着还行。
我当时第一反应是:它跟 Seedance 比能力如何?
于是我把自己在 Seedance 上用的同一套提示词拿过来,在 Muse 这里试了一下——效果还可以,画面、运镜、氛围都在线,大家也可以感受下。
提示词:
【整体设定】

2005 年盛夏的台湾校园青春偶像剧。两名刚满 18 岁的高中生情侣放学后骑自行车回家。男生穿白色短袖校服衬衫、深蓝长裤和帆布鞋,女生穿白色短袖校服、深蓝百褶裙和白色帆布鞋,两人背着略显旧的双肩书包,各骑一辆银色复古自行车。

场景是校园外的林荫小路,路旁有低矮民居、旧式中文招牌、电线杆和盛开的凤凰木。阳光穿过树叶形成斑驳光影,空气里带着盛夏午后的明亮与潮湿感。整体呈现 2005 年台湾青春偶像剧风格,清新、浪漫、青涩,带有轻微柔焦、高光泛白、低对比暖色和复古电视画面质感。

【0–5 秒】

放学铃声刚结束,两人骑着自行车从校园门口并肩驶出。男生稍微加速后回头看向女生,嘴角带着克制的笑意;女生迎着风眯起眼睛,头发和裙摆轻轻摆动。侧面中远景平稳跟拍,树影快速掠过车轮与校服,远处传来蝉鸣和自行车链条转动声。

【5–10 秒】

女生轻轻按响车铃,笑着对男生说:“等我一下啦。”男生放慢速度,两人的自行车重新并排。镜头切到正面中景,缓慢向后移动,保持两人始终位于画面中央。女生低头忍住笑意,随后抬眼看向男生;男生短暂移开视线,耳朵微微泛红。两人的动作自然、克制,带有初恋般的青涩感。

【10–15 秒】

两人骑进凤凰木覆盖的长坡,夕阳从道路尽头照来。女生向前伸出一只手感受迎面的风,男生转头看她,两人同时笑起来。镜头切到背后远景并缓慢拉远,两辆自行车并肩驶向金色夕阳,树叶被风吹落,最后定格在两人的背影和被阳光拉长的影子上。

【画面与声音】

4:3 复古电视偶像剧构图,2005 年台湾青春剧质感,夏日暖黄色自然光,柔和逆光,轻微高光溢出与胶片颗粒,色彩清新但不过度饱和。背景音乐使用轻快克制的木吉他与钢琴旋律,融合蝉鸣、风吹树叶、自行车铃声和链条转动声;对白清晰自然,音乐不遮盖人声。

【约束条件】

全程只保持同一对18岁情侣作为主要人物,面部、发型、校服、书包和自行车前后一致;骑行动作符合真实物理规律,手脚结构正常,车轮转动和人物重心自然;不出现智能手机、现代电动车、现代汽车、LED广告牌或其他明显晚于2005年的物品;无字幕、无水印、无多余文字;人物面部稳定,无变形、闪烁、穿模或角色数量变化。
seedance 2.0:
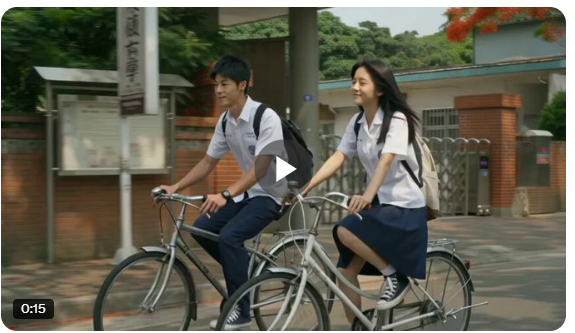
Muse video :
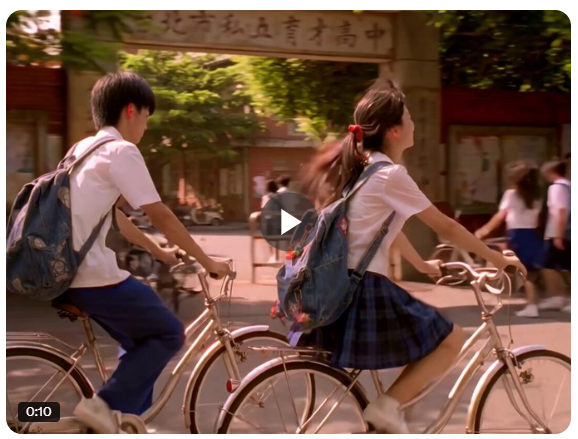
但Muse 的视频模型一次就生成约 10 秒,时长不可调。想做长视频,只有一条路:一段一段生成,再拼接起来。
我跟 Muse 沟通它说他可以直接拼接出片,这样连剪辑都省了。
三、能不能做成 3 分钟一集?
一个 10 秒镜头和一部 3 分钟一集的漫剧之间,差的不是技术,是方法。
3 分钟 = 180 秒,按每镜 10 秒拆,一集就是 18 个分镜。18 个镜头怎么保证是同一个人、同一个场景、同一个故事?人物不能这一镜一个样,剧情不能断,台词不能乱——这才是真正的难题。
刚好我前段时间开发了一个漫剧创作出海战的工具,我就结合我这个产品中漫剧制作六部方法论:
剧本 → 分镜表 → 资产(人物/场景/道具)→ 锁定资产 → 逐镜生成 → 拼接
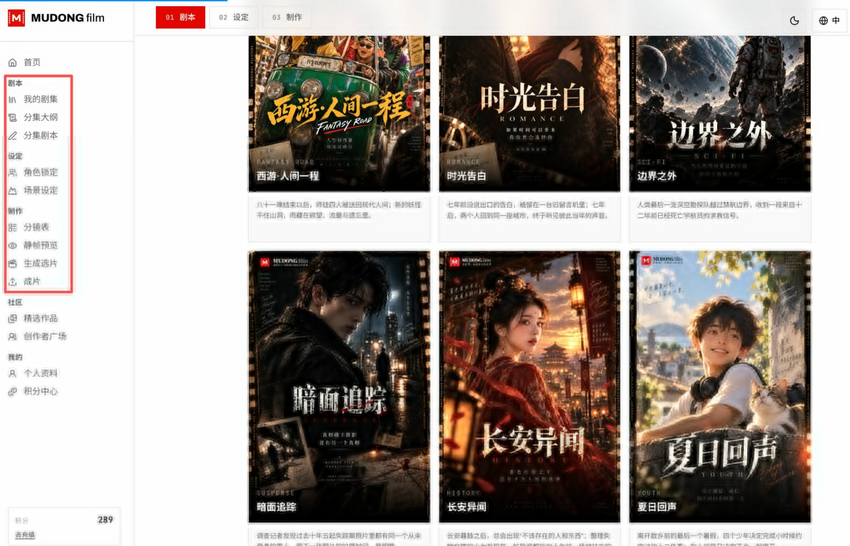
这套工作流 Muse 承包拆分镜、写提示词、生成资产、质检、拼接,我只干两件事:拍板,审片。规矩是"一镜一确认"——生成一条,我看过点头,再做下一条。
基本还原了我之前开放的这个产品的核心方法论。
四、关键在中文配音上
于是我把漫剧工作台现有的《长安异闻》剧本发给它,让它去实测效果。
流程跑起来后,第一个大坑出现在中文题材上。Muse 的视频模型在配音和文字这两块很薄弱,我结结实实撞了两次:
第一次,"边跑边喊"全军覆没。《长安异闻》里我要一个镜头:阿七边跑边喊"让一让",纯背影。第一轮三版全是哑巴,一句台词没有;第二轮三版有声音了,但每到喊话那一秒,阿七必转头对着镜头喊。我写了三种不同强度的"不许转头",全被击穿。最后我拍板:台词取消,用最早那版的第 4–10 秒,纯奔跑。
第二次,"沈书吏"念成"行速力"。中文对白的发音是模型的系统性缺陷,重拍解决不了。后期配音我也试了,TTS 的台湾口音被我自己否了——"还是老外味"。
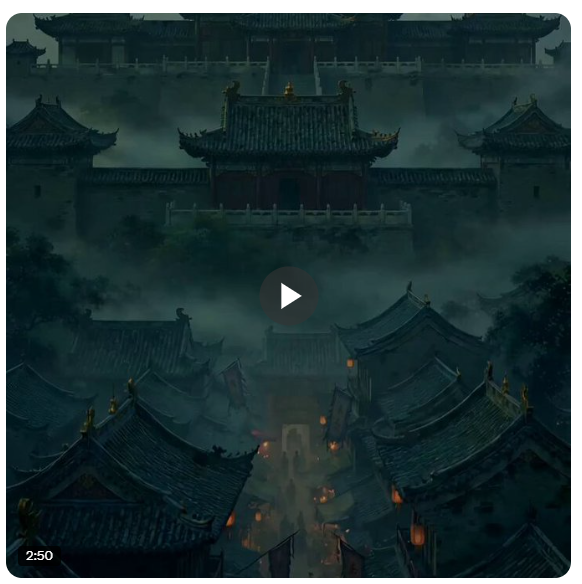
(由于不能上传视频,效果可以在微信群看)
上面这个问题让我我认清现实:做漫剧不是"实现导演意图",而是"在模型的可达域内找最优解",导演意图得给模型能力让路。
五、让 Muse 去啃 Seedance 2.5 的官方文档
既然拼的是提示词,那我就把提示词这件事做到极致。
我找来 Seedance 2.5 的官方提示词文档,让 Muse 逐字学习、总结 prompt 技巧;又对照了 Higgsfield 开源 AI 长片《Hell Grind》的方法论(人家用 Seedance 做了 95 分钟,全套 prompt 开源)。两边校准完,几条关键结论直接改了我的打法:
资产先行:Higgsfield 的原话——"不锁定全部资产,一个镜头也不生成"。人物描述词一旦冻结,每个分镜提示词里一字不许改,"模型没有记忆,少描述一句,下一镜他就换脸换夹克"。
三视图人物锁被官方劝退:我之前用三视图锁人物,官方文档明确说不要——模型会把同一角色的不同角度认成不同的人。改成"面部特写+全身照"。
英文写描述,中文说台词:Aqi says in Mandarin {让一让,让一让},人名加拼音注音,专治发音跑偏。
否定约束只对字幕和音频有效,画面上想"不要"什么,得用肯定式表达。
情绪不写抽象词:不写"悲伤",写"低头、肩膀轻颤、手指无意识攥衣角"。
一镜只许一种运镜,复杂动作必须放开场。
六、最后跑通的流程长这样
融合seedance 提示词技巧和我的实战教训,现在的标准流程是:
|
步骤
|
Muse 干什么
|
我干什么
|
|---|---|---|
|
剧本 → 分镜表
|
拆成 18 镜,标景别、运镜、动作、对白落点
|
审故事,锁定
|
|
资产清单
|
从分镜表反推人物/场景/道具,写生成提示词
|
—
|
|
生成资产
|
生成+同框测试
|
验收,锁定
|
|
逐镜提示词
|
英文描述+中文台词,资产描述逐字复用
|
—
|
|
逐镜生成
|
生成 → 质检(逐秒验帧/剧本对照/台词试听)
|
逐镜确认
|
|
拼接交付
|
拼接、调色、每条首尾各剪半秒
|
终审
|
两条红线:
一镜 10–15 次迭代不收敛就简化镜头,不许烧生成次数;
原生对白做不出来就改镜头设计,永远不走后期配音。
实战数字:一个分镜平均 3–4 次生成换 1 条可用,一集 18 镜,50–70 次生成是常态。慢,但是可控。
七、喂饭照着来
分三层:
第一层:先玩转 10 秒。
别一上来就想做剧。先让 Muse 给你生成一个 10 秒的镜头:一个人、一个动作、一种运镜、一句台词,全写进提示词里。你会立刻碰到真实的问题——人物长得对不对、台词出没出声、运镜飘不飘。把这一个镜头玩明白,提示词的手感就有了。Seedance 的官方文档这时候再去读,每句话你都看得懂。
第二层:拿流程跑通一集。
找个 3 分钟的小故事,走完整整六步:分镜表 → 资产 → 锁定 → 逐镜生成 → 拼接。重点不是成片有多精美,是把"资产先行""一镜一确认""一次改一行"这三条纪律练成肌肉记忆。第一集一定会翻车,翻车的记录就是你最值钱的东西——我到现在还留着每次失败的提示词版本。
第三层:跑通一集,再谈系列化。
一集跑通之后,真正的挑战才来:人物跨集一致、风格统一、生产速度。这时候再去看 Higgsfield 的开源项目,人家 95 分钟是怎么管资产、怎么写 tag 字典、怎么做生产日志的。路是一样的,只是规模变大。
一句话:10 秒练手感,一集练流程,系列化练管理。别反过来。
Muse 目前的活动诚意很足,一个账号 310 亿 token,用来做漫剧练手也不错。
我前后大概生成了 100 多个 10s 的视频,跑完周额度送的 token 就花了 1 亿
还没注册的填这个邀请码:QVR6NR